
GPT Image 2.5 im Praxistest: Erste Eindrücke aus dem Studio
GPT Image 2.5 im Praxistest: Geschwindigkeit, natürliches Licht, Referenztreue und Mehrfach-Edits im Vergleich zu GPT Image 2 — plus ein erster Workflow auf bikabika AI.
Der Kunde wollte bis Mittag drei Varianten für ein Produktstillleben — und am Nachmittag eine Porträtserie mit gleichem Gesicht, anderem Hintergrund. Statt erst eine lange Modellbewertung zu schreiben, habe ich GPT Image 2.5 (ChatGPT Images 2.5) direkt mit den Aufträgen gefüttert, die ich ohnehin liefere: gleicher Prompt für Tempo, Referenzbilder für Szenenwechsel, pro Runde nur eine Änderung, dann Skizze und fixierte Kommentare. Das sind meine Praxis-Eindrücke — was sofort auffällt, wo noch Übung nötig ist, und wie du es auf bikabika AI nachbaust.
Hintergrund zum Vorgänger: Was ist GPT Image 2. Dieser Text dreht sich nur um das Gefühl von 2.5 in der ersten Session.
Kurzfassung: 2.5 fühlt sich an wie Generierung, die man mitbearbeiten kann
Gegenüber GPT Image 2 war die erste Woche nicht «plötzlich künstlerischer». Es waren vier Schichten, die zusammen wirken:
- Schnellere Generierungen — gleicher Prompt, gleiches Format, weniger Wartezeit (OpenAI nennt bis zu ~50 % geringere Latenz)
- Natürlicheres Licht und Material — Haut, Stoff und Metall mit weniger Plastik-Glanz
- Stabilere Motive aus Referenzen — Gesichter und Verpackungen driften weniger beim Set-Wechsel
- Mehrfach-Edits, denen man eher traut — lokale Korrekturen reißen seltener das ganze Bild ein
Skizze und Kommentar-Pins sind der Bonus: Wenn die Struktur schon da ist, brauchst du weniger zu erklären; bei chirurgischen Fixes markierst du die Stelle.
So habe ich getestet
Alle Läufe liefen im bikabika-AI-Bildworkspace mit GPT Image 2.5:
- Text-zu-Bild: 3–5 Frames aus einem Prompt, um Tempo und Stabilität zu spüren
- Referenzen: Gesichts- / Packshot-Uploads mit expliziter Behalten/Ändern-Liste
- Mehrfach-Runden: pro Durchlauf nur eine Änderung (Licht, Requisite oder Textbereich)
- Baseline: derselbe Brief auf GPT Image 2 zum direkten Vergleich
Prompts blieben konkret — Motiv, Objektiv, Lichtrichtung, Materialien — statt Vibe-Adjektive. Wo Identität zählt, schlagen Referenzen lange Prosa.
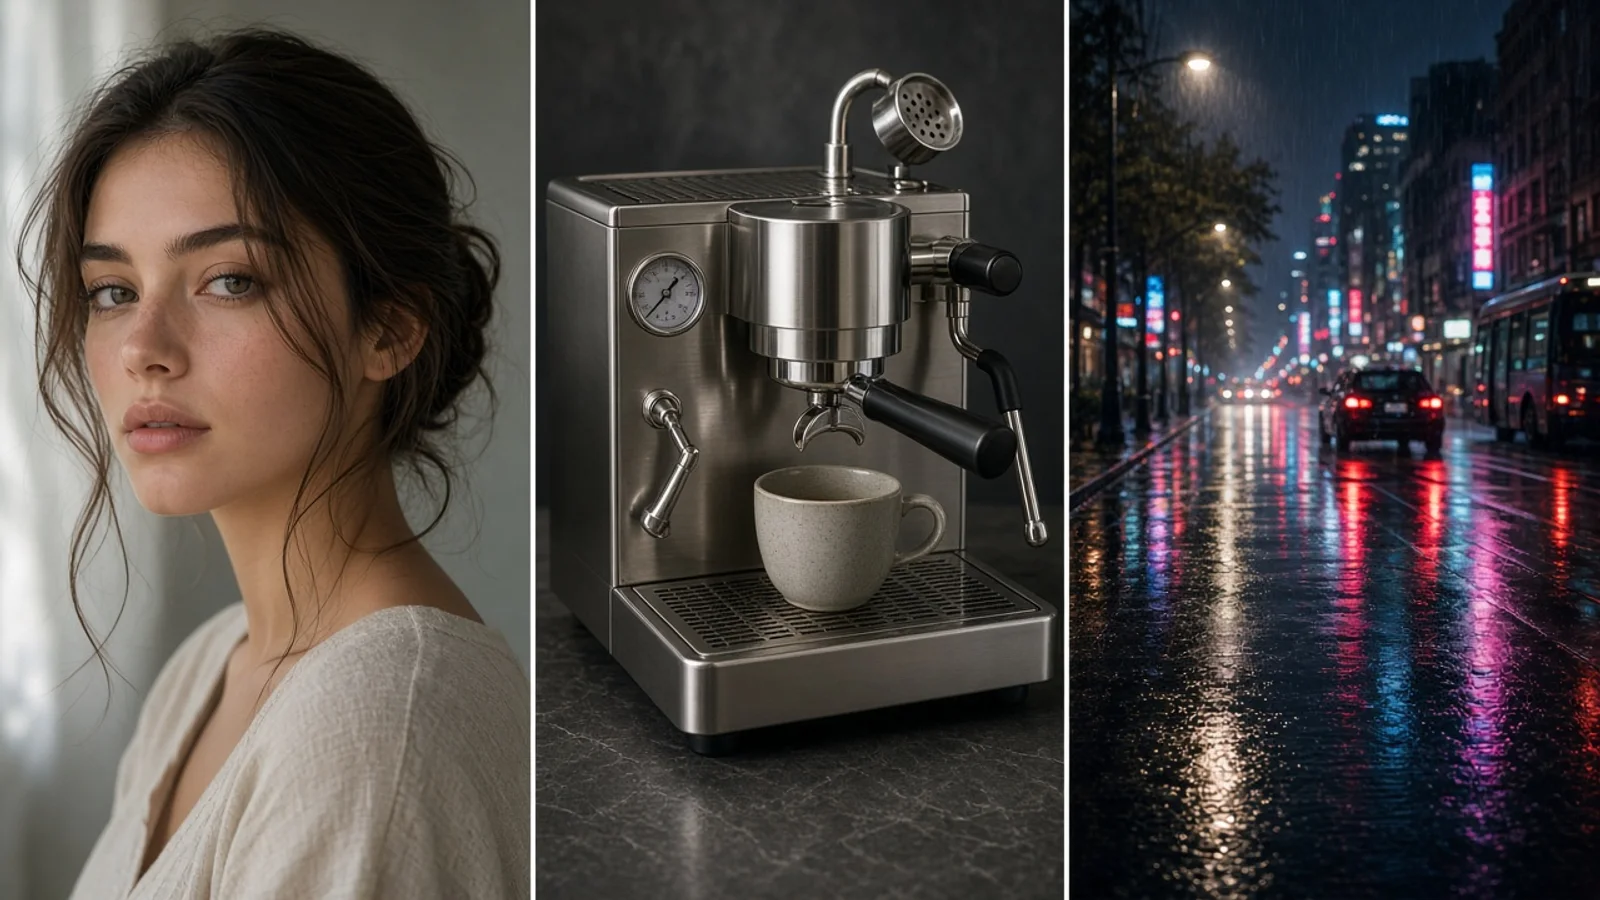
Eindruck 1: Tempo verändert, wie oft du entwirfst
Bei Image 2 dachte ich instinktiv «warten, dann die nächste Zeile überlegen». Bei 2.5 fühlt sich die Warteschlange leichter an — Entwurfsdichte steigt, zwei Varianten mehr für ein Review kosten kaum Nerven.
Schnell heißt nicht final. Mein Rhythmus: Richtungen erkunden, Komposition und Motiv fixieren, dann Qualität hochziehen oder den Präzisionspfad wählen (in API-Sprache Flare vs. Sunburst — Durchsatz vs. Feinschliff).
Eindruck 2: Natürliches Licht nimmt «Licht nachbessern»-Stress
Frühe fotorealistische Porträts und Produktstillleben zeigten Seitenfensterlicht, weiche Schatten und Stoffstruktur näher an einem echten Shoot. Formulierungen, die ich früher überbetont habe («Studio-Softbox», «weniger Plastik»), trugen mit weniger Prompting.
Es scheitert noch, wenn das Licht vage bleibt («schöne Beleuchtung»). Richtung, Tageszeit und Schattenhärte benennen — sonst bleibt der Vorteil unsichtbar.
Eindruck 3: Motivtreue macht Szenenwechsel weniger riskant
Mit fixiertem Gesichts- oder Flaschen-Ref habe ich nur Hintergrund und Jahreszeit geändert. 2.5 hielt Silhouette und Verpackungsform stabiler — kein Null-Drift, aber weniger «neues Gesicht nach Set-Wechsel».
Schreib die Behalten-Liste zuerst: «Gesicht und Haare behalten; nur Café-Hintergrund», «Flasche und Label-Typ behalten; nur Tischmaterial ändern».
Eindruck 4: Mehrfach-Edits fühlen sich wie Zusammenarbeit an, nicht wie Lotterie
Drei Durchläufe: Rahmen fixieren → linkes Key-Licht anheben → Manschette umlackieren. 2.5 ließ eher die guten Teile stehen. Trotzdem pro Runde nur eine Änderung; Region pinnen, wenn möglich. Fünf Edits in einem Prompt verwirbeln jedes Modell.
Eindruck 5: Skizze und Kommentare sind optional — aber kleben
Ein Whiteboard-Strich vor den Stilnotizen schlug Absatz-Geometrie jedes Mal. Fixierte Kommentare glänzen bei «nur hier»: Textblock, Manschette, Hintergrund-Unordnung.
2.5 geht auch rein per Text. Mit Struktur vorgegeben, vollendet es deinen Rahmen statt einen neuen zu erfinden.
Gegen GPT Image 2: wann 2 behalten?
| Du legst Wert auf | Tendenz |
|---|---|
| Schnelle Boards, dichte Exploration, weniger Warten | GPT Image 2.5 |
| Fotorealistisches Licht und Material | GPT Image 2.5 |
| Referenzgeführte Szenen- / Charakterkontinuität | GPT Image 2.5 |
| Mehrfach-Lokals, Skizze, fixierte Kommentare | GPT Image 2.5 |
| Reife Image-2-Prompt-Bibliothek; schwere Reasoning- und Multi-Ref-Basis | Bei GPT Image 2 bleiben, kritische Jobs auf 2.5 A/B-testen |
Faustregel: Neues standardmäßig auf 2.5. Alte Prompts nicht blind migrieren — denselben Brief nebeneinander laufen lassen.
Checkliste für die erste Session
- GPT Image 2.5 Modellseite oder Bildworkspace öffnen
- Text-zu-Bild: drei Richtungen; Komposition fixieren
- Referenzen und Behalten-Liste, wenn Identität zählt
- Pro Runde eine Änderung; Skizze hochladen, wenn Blocking da ist
- Qualität für den finalen Export anheben
Schicht-Prompt-Craft aus dem GPT Image 2 Prompt-Guide wiederverwenden, dann Licht-Sprache und Behalten/Ändern-Zeilen für 2.5 härter formulieren.
FAQ (Erste Session)
Sind ChatGPT Images 2.5 und GPT Image 2.5 dasselbe?
Gleiche Generation, andere Namen: Produktoberflächen sagen oft ChatGPT Images 2.5; Modell/API-Sprache meist GPT Image 2.5. Auf bikabika AI GPT Image 2.5 wählen.
Was überschätzt man am leichtesten am ersten Tag?
Tempo. Mehr Entwürfe heben die ästhetische Decke nicht von allein — Vorgaben, Referenzen und deine Shortlist entscheiden.
Muss ich Skizze und Kommentare nutzen?
Nein. Text-zu-Bild ist schon schneller und stabiler. Skizze/Kommentare beschleunigen Jobs mit Struktur oder fixiertem Patch.
Fazit
GPT Image 2.5 im Praxistest, erster Durchlauf: Es rückt «Warten lohnt sich», «Nachbearbeiten lohnt sich» und «Referenzen halten» näher an den Alltag. Prüf es mit deinem eigenen Brief in GPT Image 2.5 auf bikabika AI — drei Runden mit einem Prompt, dem du ohnehin vertraust, schlagen jede Scorecard.