
GPT Image 2.5 sul campo: prime impressioni dal workflow reale
Prime impressioni di GPT Image 2.5 sul campo: velocità, luce naturale, fedeltà del soggetto e edit multi-turno rispetto a GPT Image 2 — con un workflow per la prima sessione su bikabika AI.
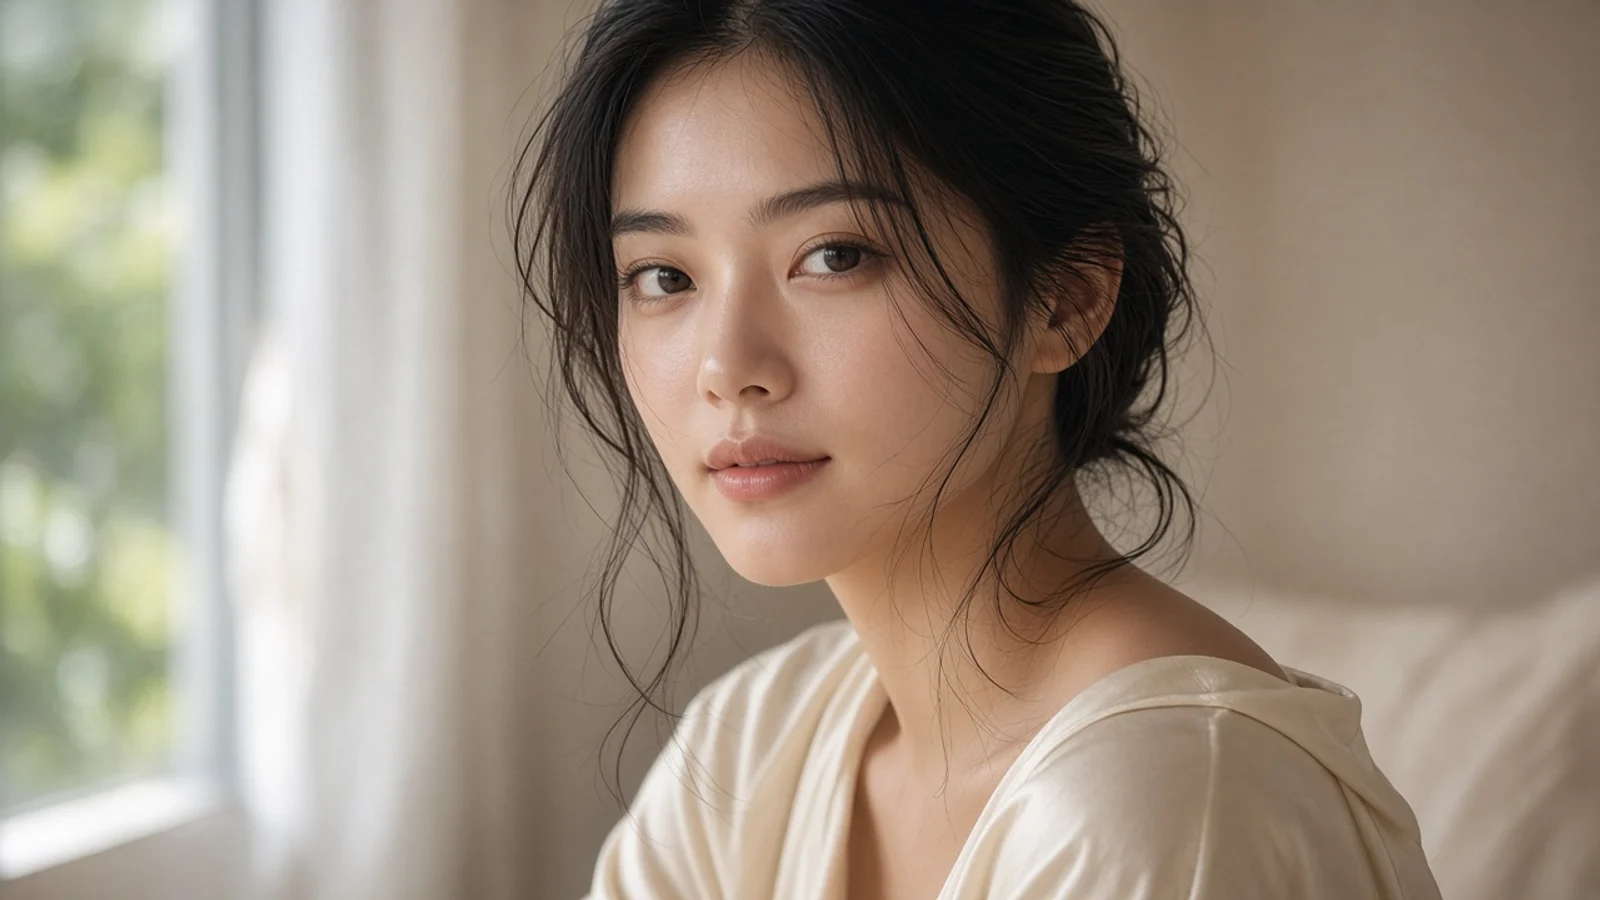
Il brand manager ha chiesto tre direzioni visive entro pranzo — stesso volto, tre ambientazioni diverse per la campagna autunnale. Invece di scrivere una recensione lunga, ho messo GPT Image 2.5 (ChatGPT Images 2.5) al lavoro sui deliverable che già consegno: stesso prompt per misurare la velocità, reference per cambiare set, una modifica per round, poi sketch e commenti fissati. Ecco le prime impressioni sul campo — cosa salta subito all’occhio, cosa chiede ancora pratica, e come replicarlo su bikabika AI.
Per il contesto sul modello precedente, vedi Cos’è GPT Image 2. Questo pezzo parla solo di come si sente 2.5 in una prima sessione.
In sintesi: 2.5 sembra generazione che puoi revisionare
Rispetto a GPT Image 2, la prima settimana non è stata «improvvisamente più artistica». Sono stati quattro guadagni sovrapposti:
- Generazioni più veloci — stesso prompt e inquadratura, meno attesa (OpenAI cita fino a ~50 % di latenza in meno)
- Luce e materiali più naturali — pelle, tessuto e metallo con meno effetto plastica
- Soggetti più stabili dalle reference — volti e packaging derivano meno quando cambi il set
- Edit multi-turno più affidabili — le correzioni locali distruggono meno l’intero frame
Sketch e commenti fissati sono il bonus: quando hai già struttura, parli meno; per un fix chirurgico, segni il punto.
Come ho testato
Tutti i run nel workspace immagini bikabika AI con GPT Image 2.5 selezionato:
- Testo a immagine: 3–5 frame da un prompt per sentire ritmo e stabilità
- Reference: upload volto / packshot con lista esplicita conserva/cambia
- Multi-turno: una modifica per round (luce, prop o area copy)
- Baseline: stesso brief su GPT Image 2 per confronto diretto
Prompt concreti — soggetto, obiettivo, direzione luce, materiali — niente aggettivi vibe. Quando conta l’identità, le ref battono la prosa lunga.
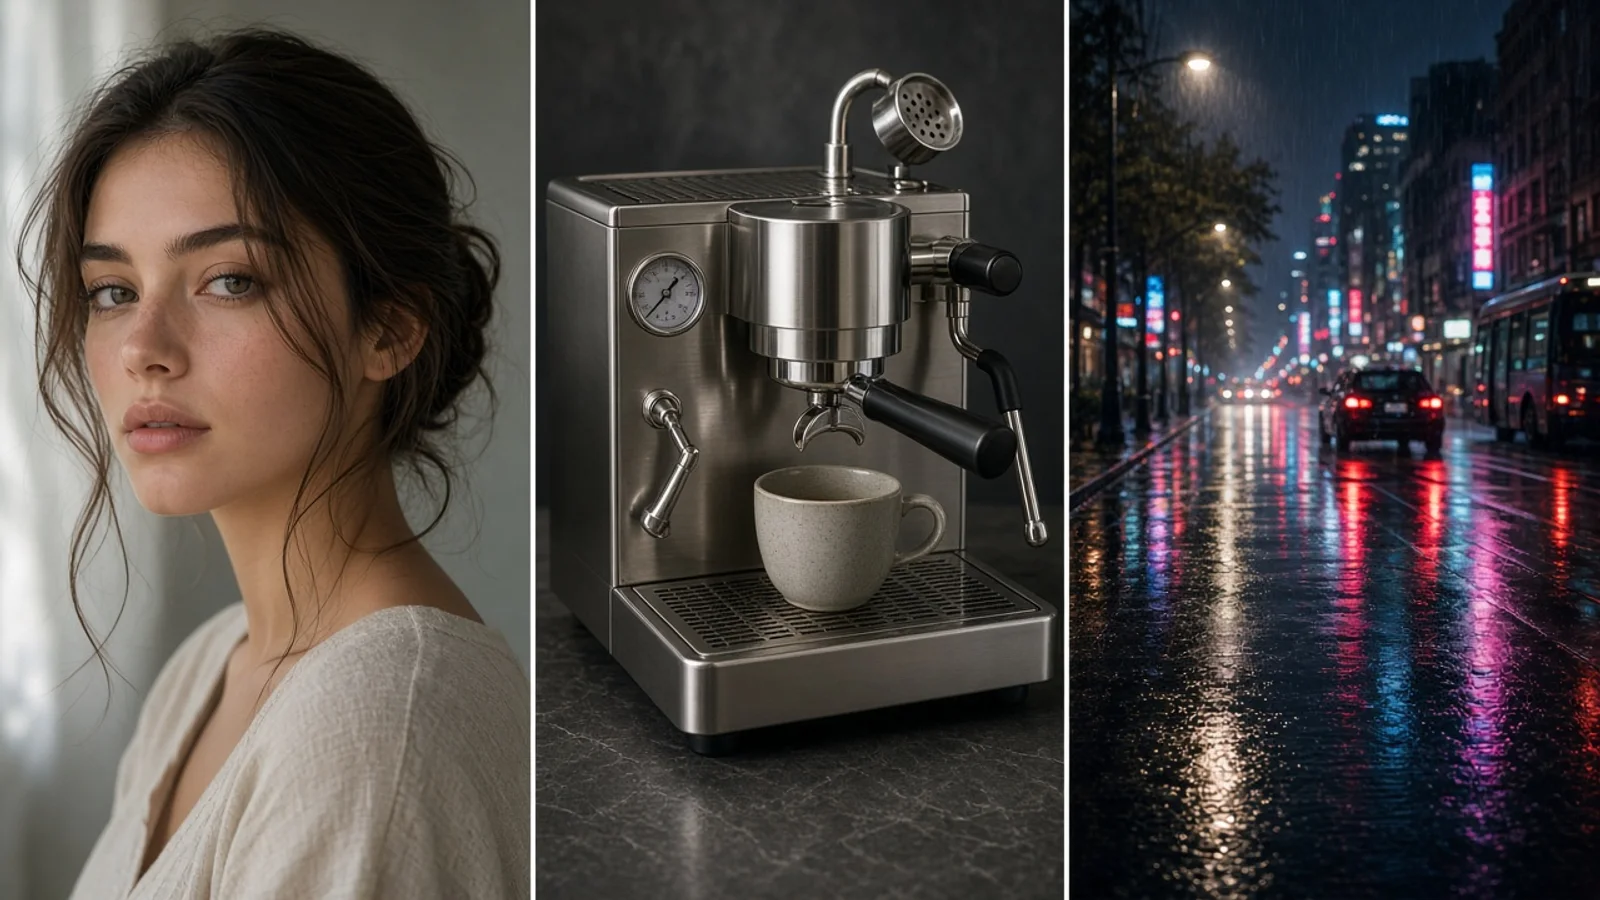
Impressione 1: la velocità cambia quanto bozzi
Con Image 2 pensavo istintivamente «aspetto, poi invento la riga successiva». Con 2.5 la coda sembra più leggera — sale la densità di bozze, due varianti in più per una review non pesano più.
Veloce non è finale. La mia abitudine: esplorare direzioni prima; bloccare composizione e soggetto; poi alzare qualità o prendere la via precisione (in API, Flare vs Sunburst — throughput vs finitura).
Impressione 2: la luce naturale riduce l’ansia «sistemare illuminazione»
I primi ritratti fotorealistici e still life prodotto mostravano luce laterale da finestra, ombre morbide e trama del tessuto più vicini a uno shoot vero. Frasi che prima sovraspecificavo («softbox studio», «meno plastica») rendevano di più con meno prompting.
Fallisce ancora se la luce resta vaga («bella illuminazione»). Nomina direzione, ora del giorno e durezza ombre — altrimenti il vantaggio non si vede.
Impressione 3: la tenuta del soggetto rende meno rischioso cambiare set
Con ref volto o bottiglia bloccato, ho cambiato solo sfondo e stagione. 2.5 ha tenuto meglio silhouette e forma del packaging — non zero deriva, ma meno disastri «nuovo volto dopo swap di set».
Scrivi la lista conserva per prima: «conserva volto e capelli; solo sfondo caffè», «conserva bottiglia e tipo etichetta; cambia solo materiale tavolo».
Impressione 4: l’edit multi-turno sembra collaborazione, non lotteria
Tre passate: blocca inquadratura → alza key sinistra → ricolora polsino. 2.5 lasciava più spesso intatte le parti buone. Resta una modifica per turno; fissa la regione quando puoi. Cinque edit in un prompt confondono qualsiasi modello.
Impressione 5: sketch e commenti non sono obbligatori — ma restano
Una linea da lavagna caricata prima delle note di stile ha battuto la geometria a paragrafo ogni volta. I commenti fissati brillano per «solo qui»: blocco copy, polsino, disordine di sfondo.
2.5 funziona anche solo testo. Con struttura in input, completa il tuo frame invece di inventarne uno.
Rispetto a GPT Image 2: quando restare su 2
| Ti importa soprattutto | Orientamento |
|---|---|
| Board veloci, esplorazione densa, meno attesa | GPT Image 2.5 |
| Luce e materiali fotorealistici | GPT Image 2.5 |
| Continuità scena / personaggio guidata da ref | GPT Image 2.5 |
| Local multi-turno, sketch, commenti fissati | GPT Image 2.5 |
| Libreria prompt Image 2 matura; base reasoning + multi-ref pesante | Restare su GPT Image 2, A/B consegne critiche su 2.5 |
Regola pratica: nuovo lavoro di default su 2.5. Non migrare alla cieca ogni prompt vecchio — lancia lo stesso brief affiancato.
Checklist prima sessione
- Aprire la pagina modello GPT Image 2.5 o il workspace immagini
- Testo a immagine: tre direzioni; blocca composizione
- Aggiungere ref e lista conserva quando conta l’identità
- Una modifica per turno; caricare sketch se hai blocking
- Alza qualità per l’export finale
Riutilizza il craft a strati dalla guida prompt GPT Image 2, poi indurisci linguaggio luce e righe conserva/cambia per 2.5.
FAQ (prima sessione)
ChatGPT Images 2.5 e GPT Image 2.5 sono la stessa cosa?
Stessa generazione, nomi diversi: le superfici prodotto dicono spesso ChatGPT Images 2.5; il discorso modello/API dice GPT Image 2.5. Su bikabika AI, scegli GPT Image 2.5.
Cosa si sovrastima più facilmente il primo giorno?
La velocità. Più bozze non alzano da sole il tetto estetico — vincoli, ref e la tua shortlist decidono ancora.
Devo usare sketch e commenti?
No. Testo a immagine è già più veloce e stabile. Sketch/commenti accelerano job con struttura o fix puntuali.
Conclusione
GPT Image 2.5 sul campo, primo giro: avvicina «vale l’attesa», «vale revisionare» e «le ref reggono» alla consegna quotidiana. Verifica con il tuo brief in GPT Image 2.5 su bikabika AI — tre round di un prompt che già ti fidi battono qualsiasi scorecard.